MOST POPULAR SESSIONS
- 카테고리
- ADVANCED
- 상세
- #Back-end, #ML/AI, #Search
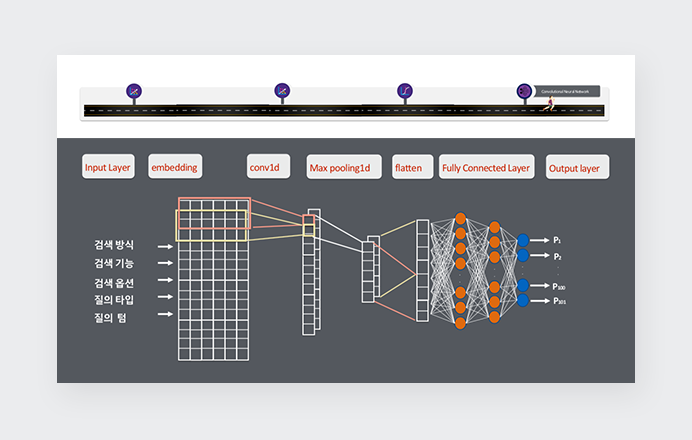
이 세션에서는 AI 비전공자인 네이버 검색 시스템 DevOps 개발자들이 검색서버 응답시간을 예측하기 위해서 기존 룰 기반 휴리스틱 방식을 대체하는 딥러닝 기술을 활용해본 사례를 소개합니다. 네이버의 대규모/대용량 검색 시스템의 응답시간을 예측하는 모델을 만들기 위해 검색 도메인에서 응답시간과 관련성 있는 feature들은 어떤 것들이 있었는지, 이를 바탕으로 단순한 회귀 모델에서부터 CNN 모델까지 예측 정확도를 높여가는 과정과 맞닥뜨린 여러가지 이슈와 경험들을 공유합니다. #### 목차 ##### 1. Why AI? - 네이버 검색시스템 구조 - 왜 검색 응답시간예측이 필요한지? ##### 2. AI Workflow - 데이터 생성부터 모델 서빙까지 단계 소개 ##### 3. Model / Feature engineering - Linear Regression - Logistic Regression - Convolutional Neural Networks ##### 4. Integration / Future Works - 검색시스템 도입 기대 효과 / 앞으로의 과제 #### 대상 - 네이버 검색 DevOps 분야에서 AI 기술이 어떻게 활용되고 있는지 궁금하신 분들. - 네이버 대용량/대규모 검색시스템의 효율성/안정성 향상을 위해 어떤 고민을 하고 있는지 궁금하신 분들. - DevOps 개발자이면서 해당 분야에 AI 기술 접목에 관심이 있으신 분들.
- 카테고리
- ADVANCED
- 상세
- #Map/Localization
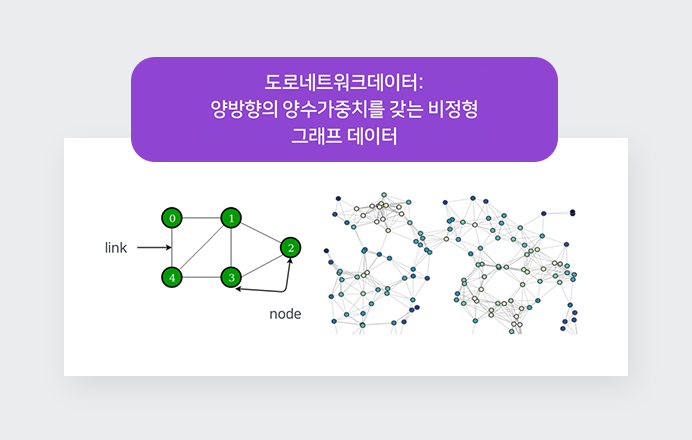
이 세션에서는 포화된 국내 내비게이션 서비스에서 이미 전문가인 운전자들에게 새로운 가치를 주기 위한 네이버 내비게이션 길찾기의 변화를 이야기하고, 다양한 결과들을 추출하기 위한 방법과 경로품질을 높이기 위한 기법들을 공유하려고 합니다. #### 목차 ##### 1. 경로 제공하기 - 자동차 길찾기 서비스 - 기존의 경로 제공 방법 - 다른 경로 제공 - 사용자가 원하는 경로는 - 다양한 경로 ##### 2. 다양한 경로 제공하기 - road network data - graph algorithm - cost function - 다양한 경로 제공을 위한 알고리즘 - k-shortest path algorithm - multi criteria optimization ##### 3. Bi-directional multi route - overview - bi-directional a* - 후보경로 추출 - 후보링크 선정 - 경로 추출 - 다양한 경로 추출 - similarity - clustering - 서비스적용 ##### 4. and more. - 정확한 소요시간 제공 - 예측 교통정보 - 정확한 소요시간 제공 - 정체 전파 #### 강연 대상 - 지도와 길찾기서비스에 관심이 있으신 분들 - 대규모의 사용자 데이터가 어떻게 가공되고 있는지 궁금한 분들 - 타사 내비게이션 서비스 사용자 분들
- 카테고리
- ADVANCED
- 상세
- #ML/AI, #Data Engineering
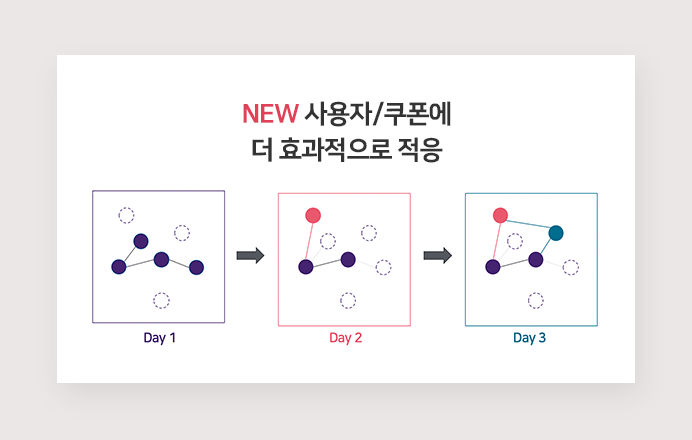
추천시스템은 기존 딥러닝 (ex>CNN, RNN)을 사용하여 성능을 크게 올릴 수 있었지만 딥러닝의 한계로 추천시스템의 또한 한계가 분명히 존재했습니다. 이 세션에서는 기존 추천시스템을 버전 2.0으로 정의하고, next step의 추천시스템에서 어떤 기술들이 중요한지 LINE Wallet 추천시스템 사례중심으로 얘기합니다. 첫번째로 LINE Wallet tab의 UI추천을 사례로 bias reduction을 얘기합니다. UI추천은 big data를 활용할 수 있는 환경을 갖추고 있지만 데이터속 bias때문에 통계적 기법의 딥러닝은 문제를 갖고 있습니다. bias reduction을 통해 CTR을 2.5배까지 올리게 되었습니다. 두번째로 LINE Wallet tab의 아이템추천을 사례로 그래프활용을 얘기합니다. 그래프뉴럴네트워크를 활용하여 cold start 문제를 완화시키고 기존딥러닝이 어려움을 겪었던 추천의 다양성과 CTR향상 두마리 토끼를 잡는 법을 공유합니다. 마지막으로 causality와 완전자동화 추천시스템을 얘기합니다. causality를 통해 오프라인테스트에서 온라인테스트를 최적화하는 방법을 소개하고, AutoML을 사용해서 시스템 관리비용을 줄여나가는 계획을 공유합니다.
- 카테고리
- FOR JUNIORS
- 상세
- #Mobile
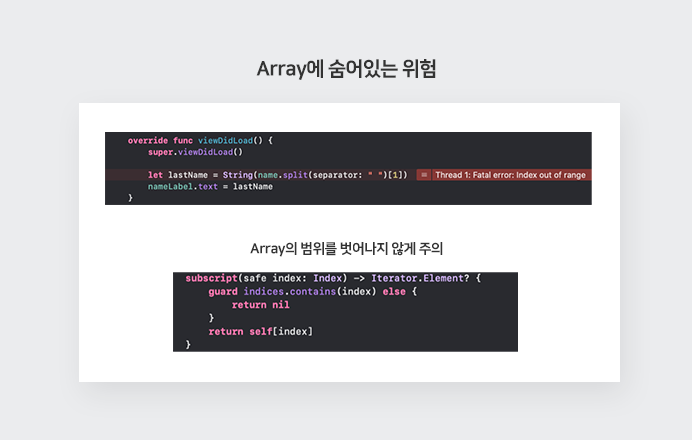
Objective-C에서 Swift로 코드를 마이그레이션 했지만 실제로 애플이 홍보했던것 만큼 앱의 안정성이 올라기지 않은 상황은 여러 사례를 통해서 확인할 수 있습니다. iOS 지도앱의 크래시를 오랜시간 발생원인과 그 양을 분석해본 결과 가장 빈번하게 발생하고 그 양이 많은 크래시들이 특정 몇몇 코딩습관에 기인하고 있다는 것을 확인 할 수 있었습니다. 크래시 개별 건별로 잡아도 잡아서는 끝나지 않는 싸움이 될 상황이나 몇개의 단순한 가이드를 잡아서 적용해본 결과 전체적으로 크래시 발생 비율을 매우 많이 감소시킬 수 있었습니다. 물론, 코딩 가이드라인이라는 것은 코딩습관에 밀접한 관계가 있고 그것을 빠르게 바꿔가기는 어렵다고 생각하실 수 있지만 최대한 복잡하지 않고 바로 적용해볼 수 있는 룰들로 충분히 큰 효과를 볼 수 있어 그 내용을 전달하고자 합니다.
- 카테고리
- ADVANCED
- 상세
- #Back-end, #Data Engineering
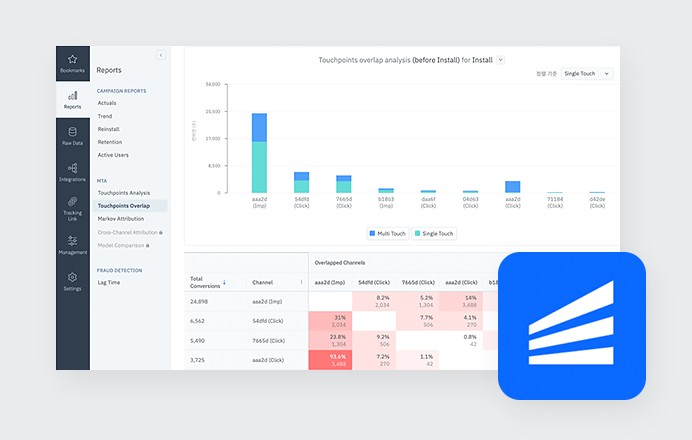
**Airbridge에서 자체 개발한 데이터스토어인 Luft의 개발기를 공유하고자 합니다.** Luft는 사용자 행동 분석에 최적화된 **실시간 분산 데이터스토어**입니다. S3과 Kafka로부터 각각 배치/실시간 데이터를 받아, 사용자 ID별로 파티셔닝해 저장하고 이를 바탕으로 리텐션 및 퍼널과 같은 사용자 행동 분석 쿼리를 수 초 이내로 수행합니다. 본 세션에서는 Luft에 대한 소개 및 개발기를 공유합니다. 국내에서 흔치 않은 데이터스토어 직접 개발이라는 경험을 통해, 대규모 분산처리 스택에 녹여져 있는 인사이트를 공유드리고자 합니다. #### 주제 *이 발표를 통해, 이런 궁금증을 해결하실 수 있습니다.* * 왜 B2B 스타트업이 데이터스토어를 직접 개발했을까? * 대규모 고성능 애플리케이션을 만들 때 어떤 원칙이 필요할까? * 장애 허용되는 분산 시스템을 만들 때 무슨 어려움이 있고, 어떻게 해결할 수 있을까? * 우리가 평소에 쓰는 DB나 Spark, Hadoop 등이 어떤 생각의 흐름으로 만들어졌을까? #### 대상 이러한 내용에 대한 사전 지식이 있으신 **데이터 엔지니어**와 **백엔드 개발자**를 대상으로 합니다. * 데이터베이스 샤딩 및 복제 * Apache Spark/Hadoop * Data ETL / OLAP #### 목차 ##### 1. 배경 - Airbridge의 새로운 기능 개발 - 기존 솔루션의 한계 ##### 2. Luft 소개 - 벤치마크 - 데모 - 데이터 쿼리 과정 ##### 3. 개발기 * TrailDB * LLVM으로 쿼리 엔진 개발 * 연산 레이어를 직접 만들기 * 샤딩 구현 ##### 4. What's next? * 로드맵 * Ziegel: A Open-Source Columnstore Made by AB180
- 카테고리
- ADVANCED
- 상세
- #ML/AI, #Data Engineering, #Search
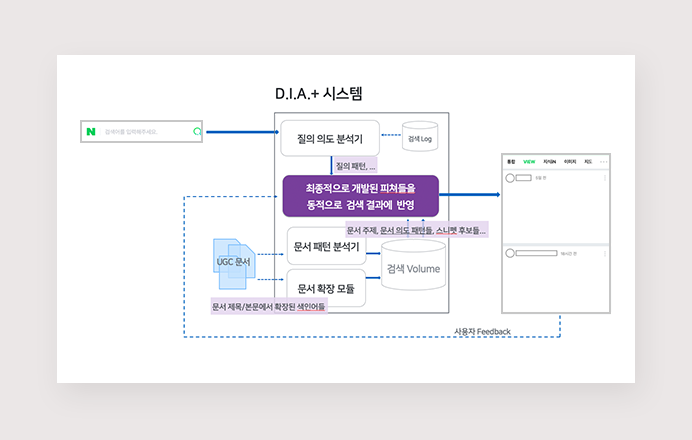
검색 중 낚시성 제목으로 낚여 실제 원하는 정보를 얻지 못한 경험이 있지 않으신가요? 하루에 수십만 개씩 쏟아지는 UGC(User Generated Contents) 문서들, 진성 경험을 담은 리뷰들과 낚시성 제목으로 사용자들의 클릭을 유도하는 문서들 틈 속에서 더는 검색어와 문서 간의 텍스트 매칭만으로는 사용자들의 검색 니즈에 부합하는 결과를 내놓기 어려워졌습니다. 따라서, 사용자가 어떤 의도를 가지고 검색했는지, 사용자가 원하는 진성 정보를 포함한 문서인지 파악하는 것은 사용자의 검색 만족도를 높이기 위해 필요한 기술입니다. 본 세션에서는 네이버 검색에서 사용자 질의 텍스트 그 자체에만 의존하지 않고, 검색 의도에 맞는 결과를 제공하는 기술을 공유합니다. 검색 의도 파악 기술과 이에 맞는 문서 분석/이해 기술, 새로운 스니펫 추출 기술과 다채로운 검색 결과를 보여준 BERT 기반의 문서 확장 기술을 소개합니다. 또한, 검색에 적용하기까지의 과정, 적용된 사례들, 적용 이후의 문제점을 공유하고, 앞으로 어떻게 발전해갈 수 있을지 이야기합니다. #### 목차 ##### 1. 검색, 사용자 관점에서 바라보기 - 문서의 의도/경험 정보 분석의 필요성: D.I.A. (Deep Intent Analysis) - 사용자 검색 의도 파악의 필요성 ##### 2. 검색 의도와 매칭되는 문서를 보여주기 위한 시도: D.I.A+ - 2.1. 검색 의도 파악하기 - 의미 기반 clustering을 통한 질의 패턴 생성 - 2.2. 문서 이해하기: 문서 속성 추출 - 문서 구조 및 컨텐츠 정보들로 가격 정보, 추천 정보 등 다양한 피쳐들 발굴하기 - 질의 의도에 맞는 매력적인 스니펫 추출하기: 너는 클릭하고 싶다. 지금. 이 문서를. - 2.3. 문서 이해하기: 문서 확장 - 대충 검색해도 찰떡같이 알아듣는 똑똑한 검색이 되기 위한 문서확장 기술 - 멋대로 쓰는 UGC 문서: 오타, 줄임말, 은어, 신조어 등 - AI/딥러닝을 활용한 검색어와 UGC 문서의 시맨틱 매칭 (feat. BERT) ##### 3. 네이버 UGC 검색에 적용하기 - 랭킹모델에 적용하기 - 문서 단위 모델링에서 의미 단위 모델링으로의 변화 - 사용자 피드백 결과 공유 - 적용 그 이후..
- 카테고리
- ADVANCED
- 상세
- #ML/AI, #Data Engineering
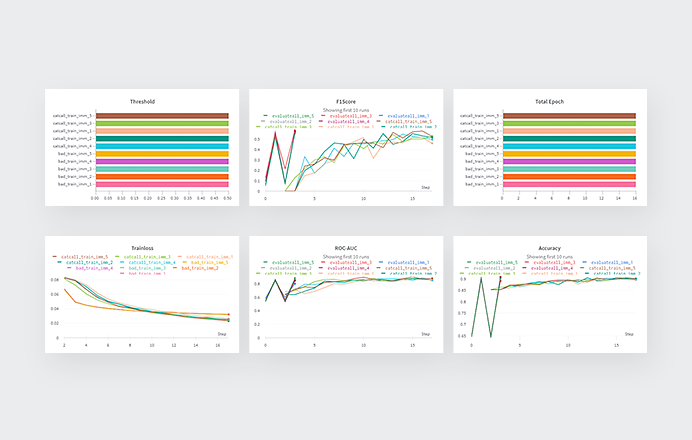
많은 사람들이 “악플”로 인하여 상처를 받고, 불편함을 겪고 있습니다. "악플"라는 명료하게 정의되어 있지 않은 사회 문제를 기술로써 풀어내기 위하여, 어떻게 **문제를 정의**하였고, 어떤 **모델과 학습 방법을 사용**하였으며, 만들어진 모델을 어떻게 **서비스** 하고, 또 무엇을 **준비**하고 있는지. 함께 더 아름다운 온라인 텍스트 생태계를 만들기 위해 공유 드립니다. keywords: Pre-training(Persona Emb.), vs BERT, Task Def., Serving #### 목차 ##### 1. 우리가 고민한 악플: 사람마다 다른 악플의 기준 - 표현의 자유 vs 누군가의 상처 - 법적, 학술적 배경 - 사회적 합의와 개인의 감성 ##### 2. 데이터 만들기: 둘이 태깅하다 하나가 죽어도 모르게.... - 태깅 규칙 정하기 - 데이터 추출하기 - 데이터 검증 ##### 3. 모델링 하기: SOTA와 Serviceablity - Tested models - CNN familly - BERT - Transfer learning으로 super-tiny모델의 한계 극복 - ELMO - Persona-embedding ##### 4. 출시 준비하기 - 정량적 평가의 한계 - Parameter tuning with AutoML - Scalable design for General and Public benefits - Test, test, and test ##### 5. 출시 후 반응 - 관련 기사에 대한 댓글들 ##### 6. UserFeedback은 오늘 - Cleanbot Red and Orange ver. - Cleanbot Phobia and Aggression ver. ##### 7. ETC - Multi-task Learning
- 카테고리
- ADVANCED
- 상세
- #Web, #Front-end
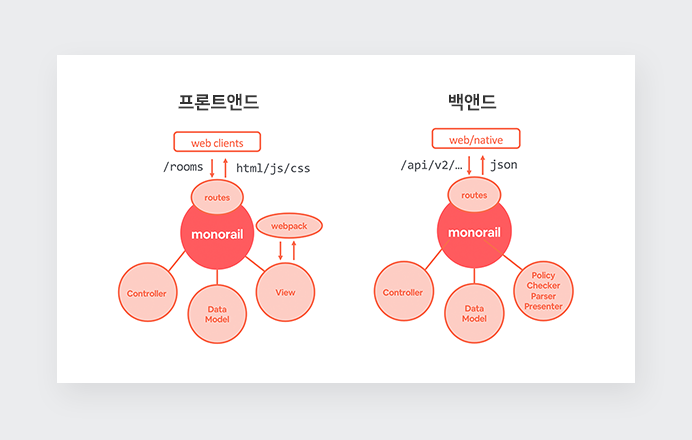
GraphQL을 한번쯤은 들어보셨나요? 개발자들 사이에 많이 언급되며 작년부터 인기가 가파르게 올라가고 있지만 아직까지 REST기반의 서비스를 대체하는데 의문이 많은 것이 사실입니다. GraphQL을 사용하는 이유는 무엇일까요? 이득 없이 유행만을 따라가는 것은 개발 리소스 낭비일 수 있습니다. 에어비앤비가 GraphQL을 선택한 이유는 무엇일까요? GraphQL이 가져다 준 이점은 무엇일까요? 이번 세션에서는 기존의 REST기반의 서비스를 유지해가며 GraphQL로 옮겨가는 과정에서 겪은 경험을 공유하며 GraphQL기반으로 프론트엔드를 구성하게되어 얻게된 여러 노하우들을 공유하고자 합니다. 기존의 REST서비스 기반의 Redux, MobX 개발자분들 중 GraphQL과 apollo를 도입을 고려하고 있다면 유익한 강의가 될 것 입니다. ### 목차 #### 1. 기존의 에어비앤비 프론트엔드 시스템과 문제점 - 기존 에어비앤비 프론트엔드 구조 - 리덕스 코드의 재활용 문제점 #### 2. Rest서비스를 유지하며 Graphql을 도입하는 과정 - thrift와 Presentation Service Framework - GraphQL 도입의 이점들 - GraphQL gateway을 사용하여 기존 REST서비스를 GraphQL서버로 사용하는 과정 - 리덕스 코드를 GraphQL 코드로 변경하는 과정 - GraphQL 스키마의 보안 처리 과정 #### 3. GraphQL이 바꿔놓은 프론트엔드 개발 환경 - 멀티플렛폼 파편화의 문제점 - SDUI (Server-driven UI)소개 - SDUI와 GraphQL Fragment 설계과정 #### 4. 미래의 에어비앤비 프론트엔드 시스템 - CLI 툴등을 이용한 자동화 과정 - API 목킹 개발 과정 - 실제 개발 시연 #### 대상 - GraphQL도입을 고려하고 있는 모든 개발자 - React환경에서 GraphQL의 효율적인 사용법이 궁금한 개발자 - 마이크로서비스구조의 REST서비스에서 좀 더 효율적인 설계가 필요한 개발자 - 에어비앤비의 프론트엔드 기술이 궁금한 모든 개발자
- 카테고리
- ADVANCED
- 상세
- #Mobile, #Map/Localization
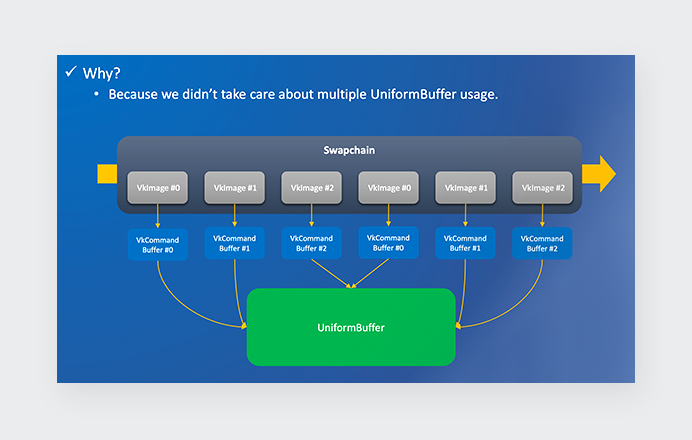
이 세션에서는 OpenGL ES 기반 지도 엔진을 Metal과 Vulkan 프레임워크로 마이그레이션 하는 과정에서 발생하는 여러 가지 이슈들에 대해 실제 경험을 바탕으로 노하우와 팁을 공유합니다. CPU 바운드가 높은 애플리케이션에 속하는 지도용 벡터 데이터를 셰이더 정점 또는 유니폼 데이터에 바인딩 처리하며 맞닥뜨렸던 문제들과 실제 성능 테스트 결과 등을 알려드립니다. #### 목차 ##### 1. 프로젝트 소개 ##### 2. Metal 정점 바인딩 ##### 3. Metal 유니폼 바인딩 ##### 4. Vulkan 정점 바인딩 ##### 5. Vulkan 유니폼 바인딩 ##### 6. 결론 및 향후 계획
- 카테고리
- ADVANCED
- 상세
- #Cloud Native, #etc
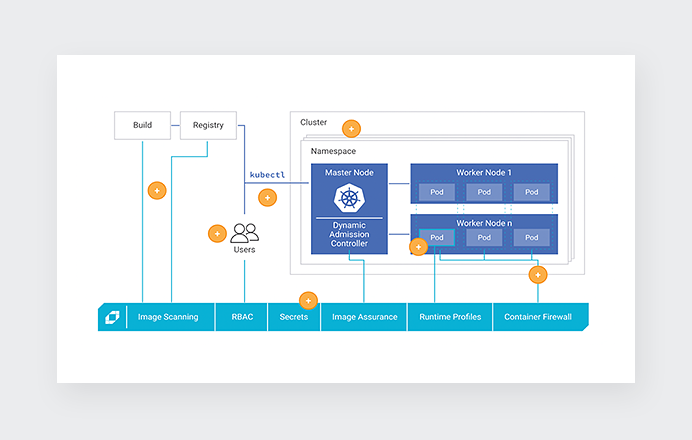
container 환경은 작고 빠르고 설정하기 쉽다는 장점으로 인해 많은 환경에서 사용되고 있습니다. 그러나 작고 빠르고 설정하기 쉽다는 container 환경의 장점들은 반대로 빠르고 체계적인 보안책이 있지 않다면 보안사고로 이어질 수 있다는 의미도 선사하는데요. 이 세션에서는 이러한 container 환경에서의 보안에 대해 일반 사용자와 플랫폼제공자등 역할에 맞춰 실천할 수 있는 방법들을 제시합니다. 또한 제가 적용했던 적용사례와 예시사례를 알아봄으로써 container환경에서 고려해야할 보안에 대해서 알아볼 수 있는 시간을 가지고자 합니다.
- 카테고리
- ADVANCED
- 상세
- #ML/AI
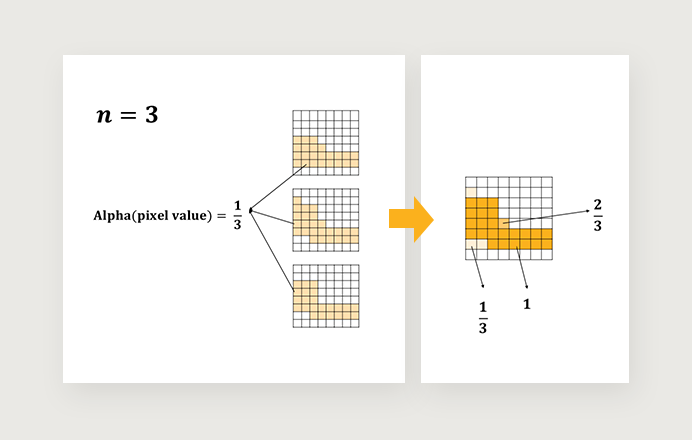
본 세션은 컨센서스 라벨링 방식으로 실제 데이터 라벨링 프로젝트를 진행한 경험을 공유드립니다. 이를 바탕으로 적합한 학습데이터 라벨링 방식을 고민하실 수 있는 정보를 얻으실 수 있습니다. 데이터 라벨링의 일반적인 작업방식은 보통 '작업-검수-최종확인'으로 이루어지는데, 문제는 검수를 담당할 인원은 확보하기도 어려울뿐더러 일반 작업비용보다 높을 수 밖에 없습니다. 우리는 라벨링의 병목인 검수 소요 감소를 핵심목표로 "다수의 선택이 정답"을 대전제로 하는 컨센서스 라벨링 품질관리 시스템 SQIP을 도입했습니다. 그 결과로 실제 프로젝트에서 전체 데이터의 4.4% 검수로 정밀도 100%, 재현율 97%를 달성했습니다. 이 외에도 스패머를 검출하기 검출하기 위해 고민한 내용, CRF를 활용한 GroundTruth Estimation 결과, 컨센서스 라벨링이 잘 작동하는 상황과 약점 등 더 나은 결과를 만들고자 시도했던 방법들을 공유하고자 합니다. #### 목차 ##### 1. 컨센서스 라벨링 - 컨센서스 라벨링이란? - 왜 컨센서스 라벨링을 사용하는가? ##### 2. 라벨링 프로젝트 주요 이슈 - 컨센서스 라벨링을 선택한 이유 - 라벨링 프로젝트 주요 이슈 - 주요 이슈 1: 작업 운영부담 - 주요 이슈 2: 검수 품질관리 ##### 3. 컨센서스 라벨링 자동화: SQIP - 참고사례: Crowd Truth - 컨센서스 라벨링 자동화 개요 - 데이터의 표현 - 지표 정의 - 정확도 향상 시도 1: 영향력 차등화 - 정확도 향상 시도 2: 불량작업 제거 로직 - 정확도 향상 시도 3: Image Matting ##### 4. 적용사례 - Instance Segmentation - Image Classification - Scene Text Localization ##### 5. 정리 #### 대상 - 데이터 라벨링이 필요한 팀 - 적합한 라벨링 방식 선택에 고민이 있으신 분 - 크라우드 소싱으로 라벨링을 진행하고 싶으신 분
- 카테고리
- ADVANCED
- 상세
- #Back-end, #etc
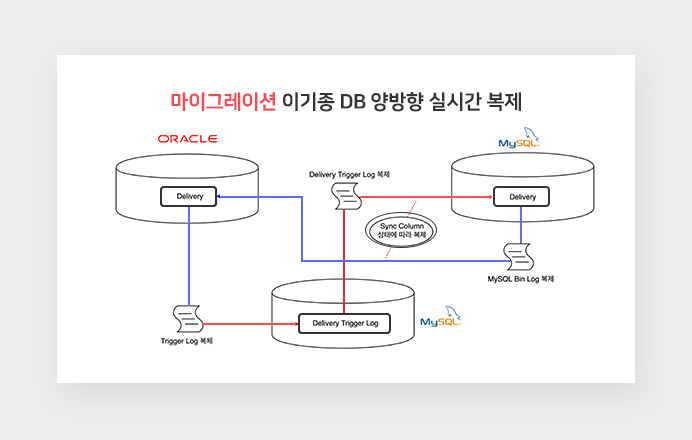
네이버 페이 서비스가 빠른 속도로 성장하면서 아키텍처 개선 및 확장이 필요해졌습니다. Plasma 프로젝트는 주문형 페이 개발자와 서비스 플랫폼 개발자가 협업해서 주문형 페이 아키텍처 개선을 목표로 진행 중인 프로젝트 입니다. 지금까지 여러 모듈을 분리 개선해왔으며, 본 발표에서는 배송 모듈을 Event-Driven Architecture 전환한 이야기를 공유합니다. 프로젝트 배경 및 이야기들은 "페이 왕국 주문 가문 배송 용사 독립기" 발표에서 다루기 때문에 본 발표에서는 아키텍처와 기술적인 관점을 집중해서 다룹니다. #### 목차 ##### 1. 모듈 분리 - 주문형 페이에서 배송의 역할 - 판매자 상품 발송 등록 - 배송 상태 트래킹 ##### 2. 인프라스트럭처 - 컨테이너 - 데이터베이스 - nBase-ARC - Kafka + ELK ##### 3. 아키텍처 - Application 구성 - Message spec - Kafka Exactly Once Semantics - Dead letter queue - Idempotent - Message flow 모니터링 및 트래픽 제어 - Message 분석 및 디버깅 ##### 4. 전환 과정 - 마이그레이션 - 전환 제약사항 - 기본 전환 전략 - 전환 - DB Sequence ##### 5. 운영 이슈 - Transaction 분리 이슈 - 주문 Transaction 종료와 배송 Consume 시간차 이슈 - N -> 1건 단위 Transaction 변경 이슈 - Kafka lag 해소 - 보정 ##### 6. 도구 활용 - Pinpoint - NELO (로그 수집) - NPOT (Metric 수집) - Grafana - ELK (Elasticsearch Logstash Kibana) #### 대상 - Scale out, 분산 애플리케이션 서비스 설계를 고민하는 개발자 - Event-Driven Architecture 설계를 고려하고 있는 개발자 - 모듈 분리 및 마이그레이션을 고민하고 있는 개발자
VIEW BY TOPICS
Front-end
- 상세
- #Web, #Front-end, #Back-end
- 상세
- #Web, #Front-end
- 상세
- #Web, #Front-end
- 상세
- #Web, #Front-end
- 상세
- #Web, #Front-end
- 상세
- #Web, #Front-end
- 상세
- #Web
- 상세
- #SRE, #Search, #etc
- 상세
- #SRE
- 상세
- #Cloud Native, #SRE
- 상세
- #Web, #Back-end, #SRE
- 상세
- #Mobile, #ML/AI, #Speech Processing
- 상세
- #Mobile, #Map/Localization
- 상세
- #Mobile
- 상세
- #Mobile, #Infra
- 상세
- #Mobile, #Media Processing
- 상세
- #Mobile, #Map/Localization